- Redis 개념과 특징2026년 09월 30일 18시 06분 37초에 업로드 된 글입니다.작성자: nickhealthy
Redis(Remote Dictionary Server)란?
Redis는 네트워크를 통해 내 컴퓨터 메모리처럼 자유롭게 확장해서 쓸 수 있는 거대한 공유 메모리 기반의 NoSQL 데이터베이스다.
다양한 자료구조와 메모리에 데이터를 저장하기 때문에 빠른 성능과 비즈니스 요구사항에 맞춰 복잡한 로직을 Redis로 간단히 처리할 수 있다. 예를 들어 글로벌 대규모 서비스에서 아래와 같은 활용 사례들이 있다.
- SNS의 수억 명의 타임라인: 각 유저의 타임라인 정보를 Redis의 List 자료구조에 미리 담아, 유저가 접속할 때 DB에 가지 않고 Redis에 있는 정보를 제공
- 선착순 이벤트와 재고 관리: 원자적 연산을 보장, 수백만 건의 주문이 몰리는 상황에서 DB 부하를 방지
- 실시간 랭킹 시스템: Redis의 Sorted Set 자료구조로 수백만 명의 데이터가 있어도 빠른 시간 내에 자동 정렬
- 매번 RDB에 요청을 보내 `ORDER BY` 구조로 설계한다면 부하가 많이 간다.
Redis 주 사용처
- Caching(캐싱): 반복되는 조회를 빠르게 처리할 때(RDB 읽기 부하 감소)
- Real-time Stats(실시간 집계): 순위, 조회수, 재고 등 실시간 계산이 필요할 때
- Session ManageMent(세션 관리): 인증 정보를 여러 서버가 공유할 때
Redis와 Memcached의 차이
Redis와 Memcached와 같은 캐시 시스템과 비슷하다고 생각할 수 있지만, 가장 큰 차이는 Redis는 문자열 외에도 List, Set, Hash, Sorted Set(ZSET) 등 다양한 데이터(자료구조) 형식을 지원한다는 차이가 있다. (Memcached는 문자열 기반의 key-value만 지원)
이러한 데이터 구조 외에도 Redis는 조금 더 많은 기능들을 제공한다. 조금 더 자세한 사항은 아래와 같다.
- 데이터 영속성(백업)
- Memcached: 데이터를 메모리에만 저장, 백업 기능 지원 X, 휘발성
- Redis: 스냅샷(RDB)이나 로그(AOF) 방식으로 데이터를 디스크에 기록
- 기본적으로 메모리 방식이기 때문에 완벽한 영속성을 보장하는 것은 어렵지만 지원되는 기능이 많다.
- 쓰레드 구조
- Memcached: 멀티스레드를 지원하며 멀티코어 CPU 환경에서 자원을 활용하기 좋다.
- Redis: 단일쓰레드 기반으로 동작하지만, 명령어 처리가 직관적이고 동시성 이슈(Race Condition)를 피하기 쉽다.
- 부가 기능
- Memcached: 기능을 최소화해 단순하고 가벼우며, 대용량으로 빠르게 캐싱하고 조회만 할 때 유리하다.
- Redis: 복제, 트랜잭션, 만료 시간 설정(TTL) 등을 지원하며, 실시간 랭킹, 로그인 세션 관리, 채팅 등 다양한 데이터 구조를 활용하거나 데이터 유실 방지가 필요할 때 사용된다.
Redis와 RDB를 같이 사용해야 하는 이유
흔히 사용하는 MySQL, PostgreSQL 같은 관계형 데이터베이스(RDB)는 기본적으로 데이터를 디스크(SSD/HDD)에 저장한다.
- 장점
- 전원이 꺼져도 데이터가 안전하게 유지된다.(비휘발성/영속성)
- 가격 대비 저장 용량이 우수하다.
- 단점
- 데이터를 읽고 쓸 땐 반드시 Disk라는 물리적인 기록 장치를 거쳐야 한다.
- 결국 병목은 물리적인 Disk I/O 발생 → 대부분의 RDB의 성능 병목은 디스크에서 발생
유저가 늘어날수록 RDB는 디스크 I/O 병목 현상에 빠지게 되고, CPU 사용량이 치솟으며 서비스 응답 속도가 기하급수적으로 느려진다. 이를 해결하기 위해 무작정 서버 사양을 높이거나(Scale-up) 서버 수를 늘리는 것은(Scale-out) 비효율적이다.
대신 Redis를 사용하게 되면 모든 데이터를 메모리에 올리고 관리하는 In-Memory 데이터 구조 저장소이기 때문에 DB에 부담을 줄여줄 수 있다.
- 병목 현상 해소: 자주 조회되는 데이터를 메모리에 캐싱하여 디스크 접근 횟수를 줄인다.
- 애플리케이션 가속: 복잡한 계산 결과나 세션 정보를 메모리에서 즉시 반환한다.
정리
- RDB(MySQL, PostgreSQL 등): 시스템에서 정확하다고 간주되는 원본 데이터 저장소(신뢰성)
- Redis: 자주 쓰이는 데이터의 임시 보관소 및 고속 연산소(속도)
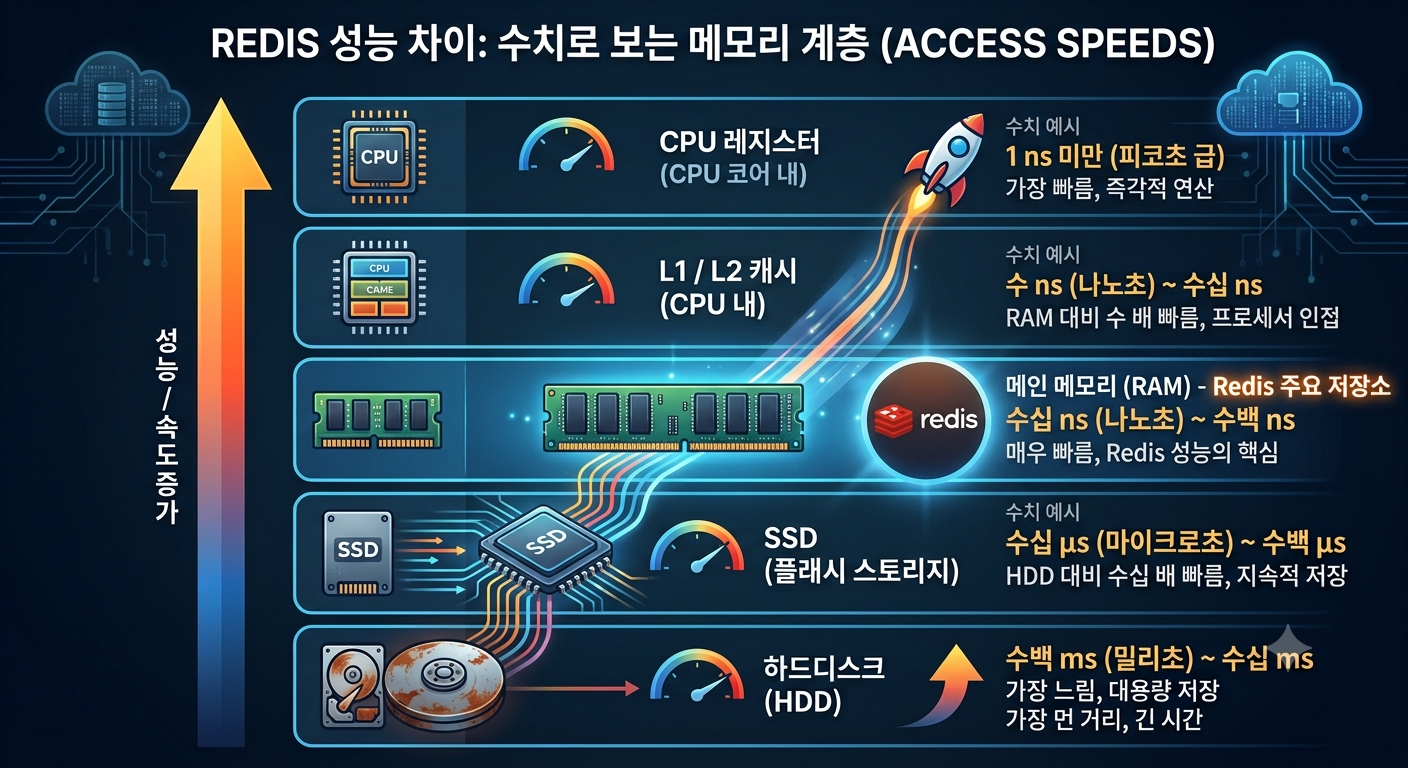
디스크와 메모리의 속도 차이
위로 갈수록 성능은 올라가지만 용량이 적고, 아래로 갈수록 성능은 떨어지지만 용량은 증가하는 구조.
RAM은 SSD보다 대략 1,000배 이상 빠르다.
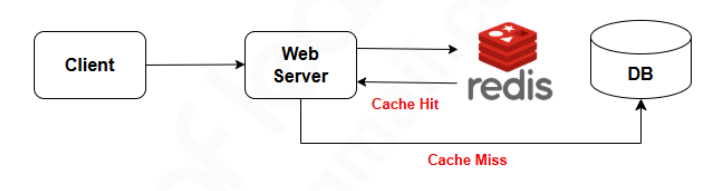
RDB와 Redis가 함께 사용될 때 가장 많이 쓰이는 전략: Cache-Aside(Look-aside)
실무에서 가장 많이 쓰이는 캐싱 전략이다. 애플리케이션이 먼저 캐시(Redis)를 확인하고(캐시 hit), 데이터가 없으면(캐시 miss) DB에서 조회하는 방식이다.
데이터 조회 흐름
- 애플리케이션은 먼저 Redis에 데이터가 있는지 확인
- Redis에 데이터가 있다면 DB에 가지 않고 즉시 반환 - Cache Hit
- Redis에 데이터가 없다면 RDB에서 데이터를 조회 - Cache Miss
- RDB에서 가져온 데이터를 다시 Redis에 저장하고 유저에게 응답
데이터 업데이트 전략: Write-Through vs Write-Back
데이터가 업데이트 되었는데 캐시된 이전 데이터를 가져오면 문제가 될 수 있다. 이를 해결하기 위해 보통 두 가지의 전략을 많이 사용하게 된다.
- Write-Through: 데이터 수정 시 Redis와 DB를 동시에 업데이트한다.(항상 최신 상태 유지)
- Write-Back(Write-Behind): 일단 Redis에만 저장하고, 나중에 한 꺼번에 모아서 DB에 저장한다.
- 로그 수집, 좋아요 수 집계 등 쓰기 성능 극대화 시 사용)
Redis의 또 다른 용도: 중앙 인메모리 저장소 역할 - 로컬 캐시(Local Cache) vs 글로벌 캐시(Global Cache)
로컬 캐시는 애플리케이션 서버 자체적으로 메모리에 담아두는 방식으로서 압도적으로 속도 측면에서는 빠르지만, 데이터 부정합(Inconsistency) 문제가 발생하게 된다. 현대 서비스는 트래픽에 따라 서버를 여러 대로 늘리게 되는데, 이때 다른 애플리케이션 서버는 메모리를 공유하고 있지 않으므로 로컬 캐시를 사용하게 되면 문제가 발생된다.
이런 문제를 해결하기 위한 한 방법으로 글로벌 캐시로 Redis를 이용하는 것이다. 모든 서버가 Redis를 공통으로 바라보게 만들어 중앙의 인메모리 저장소 역할을 하게 만들어 데이터 정합성을 보장하고, 서버의 무상태성(stateless)를 유지할 수 있게 해준다.
💡서버의 무상태성(stateless)이란?
서버가 클라이언트의 이전 요청이나 상태 정보를 기억하지 않고, 각각의 요청을 완전히 독립적으로 처리하는 아키텍처 설계 방식이다.
이로 인해 서버가 특정 상태 정보에 묶이지 않아 트래픽이 늘어나면 서버를 쉽게 늘리거나 줄일 수 있고, 서버가 이전 상황을 고려할 필요가 없어 응답 구조가 단순해지고 부하분산이 가능해지게 된다.
이를 표로 정리하면 다음과 같다.
구분 로컬 캐시(Local) 글로벌 캐시(Global) 속도 빠름 상대적으로 느림(네트워크 비용O) 데이터 일관성 서버 간 공유 불가 모든 서버가 동일 데이터 공유 용도 - 서버별 데이터(서버별 설정값)
- 변경 적은 데이터(ex 국가코드)- 공유 데이터(ex 유저 세션, 공유 캐시)
- 변경 잦은 데이터(ex 실시간 선착순 이벤트)Redis의 특징
Redis는 싱글 스레드로 설계되어 있다. 즉, 한 번에 하나의 명령어만 처리할 수 있다. 싱글 스레드라 처리 속도가 느릴 수 있을 것 같지만 초당 최대 100만 건의 요청을 처리할 수 있다고 하며, 병목은 주로 네트워크 I/O에서 생기고 처리 시간의 대부분은 네트워크 대기에 쓰인다. 명령 자체는 메모리에서 실행되므로 나노초 ~ 마이크로초 단위로 끝난다. 또한 멀티 스레드보다 싱글 스레드가 가진 이점으로 오히려 성능이 좋아질 수 있다.
싱글 스레드가 빠른 이유 - 멀티 스레드의 비용 제거
- 스레드의 생명주기 비용: 스레드가 하나이기 때문에 스레드 생성/소멸 비용이 없다.
- 컨텍스트 스위칭 비용(Context Switching) X: CPU가 여러 스레드를 번갈아가면서 상태를 저장하고 복구하는 낭비가 없다.
- 스레드 동기화용 락: 여러 스레드가 동시에 같은 데이터를 수정하려고 하면 경합(Race Condition)이 없으므로, 복잡한 잠금 메커니즘 없이도 데이터 정합성을 유지하고, 모든 명령이 순차적으로 실행되므로 원자성이 보장된다.
비동기 I/O 멀티플렉싱
Redis 6.0 버전 이상부터는 멀티 스레드 I/O가 추가되었다고 한다.
하지만 명령 실행과 클라이언트 연결 처리는 여전히 메인(단일) 스레드에서 실행하고, 영속화, 복제 같은 작업은 백그라운드 스레드가 담당한다. 또한 설정을 통해 네트워크 읽기/쓰기를 여러 스레드로 분산하고, 명령 실행은 메인 스레드에서 수행함으로서 락 없이 원자성이라는 장점은 유지한 채 네트워크 병목을 완화하는 전략을 가져가고 있다.위에서 네트워크 대기에 시간이 많이 걸린다고 하였는데, 그렇다고 해서 Redis가 블록(block)된 상태로 멈춰있는 것이 아니다.
Redis는 I/O 멀티플렉싱 기술을 사용한다. I/O 멀티플렉싱은 수많은 클라이언트의 연결을 하나의 스레드가 여러 개의 입출력(I/O) 채널이나 파일 디스크립터(네트워크 소켓 등)를 동시에 관리하고 효율적으로 처리하는 기술이다. 커널을 통해 감시하다가, 데이터가 준비된 상태(Event - Ready) 연결만 골라서 처리하는 방식이다. 따라서 요청이나 연결마다 스레드나 프로세스를 만들 필요가 없다. 그리고 순차적으로 준비된 요청을 빠르게 처리한다. 동작 흐름은 다음과 같다.
- 이벤트 루프가 데이터가 도착한 소켓만 골라냄(리눅스 - `epoll()` 사용, 변화가 생긴 이벤트만 골라 전달받는다.)
- 준비된 소켓만 논블로킹으로 읽고 명령을 파싱
- 메모리에서 명령을 실행하고 결과를 응답 버퍼에 기록
- 다시 이벤트 루프로 복귀

Redis 처리 방식 💡파일 디스크립터(File Descriptor, FD)
유닉스/리눅스에서 프로세스가 열어 둔 입출력 리소스 대상(파일, 소켓, 파이프 등)을 접근할 때 사용하는 정수 번호
동작 방식
1. 프로세스가 open(), accept()로 무언가를 열면 커널이 그 대상을 관리 테이블에 등록
2. 커널은 등록한 위치를 나타내는 정수(FD)를 프로세스에 반환
3. 이후 프로세스는 이름이나 주소 대신 그 번호로 read(fd), write(fd)를 호출
4. 커널은 각 FD가 열려 있는지, 닫혔는지, I/O가 준비가 되었는지 같은 상태를 추적함
영속성(Persistence) 처리
Redis는 기본적으로 메모리에 저장되므로 서버가 다운되면 데이터가 유실되게 된다. 하지만 이를 방지하기 위해 데이터를 디스크에 백업하는 두 가지 방식을 제공한다.
- RDB(Redis DataBase dump file format) - 스냅샷 방식
- 설명: 특정 시점의 메모리 전체 내용을 그대로 복사해서 디스크에 파일(.rdb) 형태로 저장한다.
- 장점: 파일 사이즈가 작고, 복구 속도가 매우 빠르다.(binary dump 방식이라 빠름)
- 단점: 백업 주기 사이에 장애가 발생하면 그 사이에 데이터는 유실될 수 있다.(마지막 스냅샷 이후 데이터 유실 가능)
- AOF(Append Only File) - 로그 방식
- 설명: 모든 쓰기 명령(Set, Del 등)이 발생할 때마다 그 로그를 디스크 파일(.aof)에 기록한다.
- 장점: 데이터 유실이 거의 없다.(거의 실시간 기록)
- 단점: 로그 파일이 매우 커질 수 있고, 복구 시 로그를 다시 실행해야 하므로 RDB 방식 보다 느리다.
실무에서는 보통 RDB와 AOF를 혼합해서 사용한다. 평소엔 AOF로 안전하게 기록하고, 빠른 복구를 위해 주기적으로 RDB 스냅샷을 찍는 방식을 사용한다.
DB 백업과 Redis 영속성을 표로 비교하면 다음과 비슷하다.
구분 일반적인 DB Redis 시점 저장 Full Backup(전체 백업) RDB 변경 기록 Transaction Log(로그 백업) AOF 추천 전략 주기적 전체 백업 + 실시간 로그 백업 RDB + AOF 혼합 사용 데이터 중요도에 따라 RDB, AOF 방식 중 적절한 백업 전략을 사용해야 한다.
이전글이 없습니다.댓글